10月22日,在成都举行的2026中国计算机大会(CNCC 2026)期间,中科曙光全面展示面向Token经济的智算基础设施方案,集中展出超节点、AI存储、高速网络、超集群等产品及AI推理优化服务方案,并发布可管控百万量级设备的FabricView智算网络管理平台,协同支撑Token高效生产。
AI需求升级,算力建设兼顾规模与效率
当前,大模型参数和能力持续增长,智能体激发更大推理算力需求,二者共同驱动智算基础设施向集约化、规模化方向发展。智算中心在向百万卡集群、GW级功率规模演进的同时,对计算、互连、供电、散热的效率以及系统稳定性等多方面提出更高要求。
中科曙光高级副总裁李斌在大会演讲中指出,大规模、高通量推理集群具有更高的Token生产效率。围绕“超节点+超集群”开展一体化系统工程创新,构建训推一体、极致高效、绿色节能、稳定可靠的算力系统,成为发展AI基础设施,提升Token生产效率的重要方向。这要求系统建设需统筹芯、算、存、网、电、冷等各环节之间的配合,将设备性能充分转化为实际可用的算力。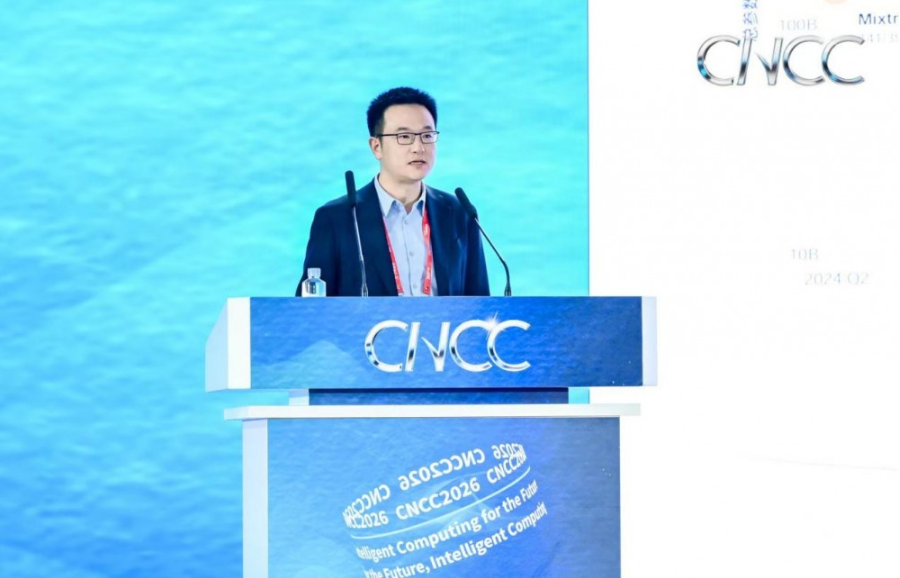
完善算存网产品,支撑大规模智算建设
面对规模与效率的双重要求,中科曙光此次展示了覆盖计算、存储与网络的系列产品,为“超节点+超集群“架构创新提供支撑。
超节点规模的选择需要匹配模型需求,并兼顾成本、收益与可靠性。scaleX40超节点通过一层组网实现全交换 scale-up,形成内存语义的百纳秒级低延迟网络,并通过无线缆正交结构与全电互连,大幅提高系统可用性,是构建高通量推理基础设施的标准单元。scaleFabric原生无损RDMA高速网络,可将多个超节点互连形成千卡、万卡、十万卡规模的超集群。ParaStor不仅为AI全流程提供统一存储池,还针对模型训推进行了算存传深度协同优化。
大会期间,中科曙光还首次发布了高速网络智能运维管理平台Fabricview,该平台专为scaleFabric 超集群网络定制研发,具备“自动化配置管理、主动性能压测筛查、业务拓扑感知调度、故障诊断自愈、全栈多维度可观测和智能运维管理“等功能,可集中纳管百万量级设备、端口与光模块。大规模网络环境下的故障定位与恢复由人工驱动转向AI代理驱动,显著提升了超大规模集群的运维效率与可靠性。
全栈全链路优化服务,加速Token高效生产
如何根据模型和业务特点优化系统,是提高Token生产效率的关键。在AI高通量推理基础设施分论坛上,中科曙光的工程师们分享了多个面向Token生产的优化方案,其中:全栈推理优化方案,针对算力空转、通信等待、访存搬运、调度排队等阻碍Token高效产出的四堵墙,围绕“算、传、存、调” 进行全链路软硬协同优化,贯穿应用、框架、算子、运行时、系统和芯片六个层级,大幅提升有效Token吞吐。PD分离架构优化方案,针对解耦预填充与解码阶段,通过资源独立配置、智能调度与KV Cache高效传输,在minimax2.5 PD分离测试中,实现P性能提升237.5%,D性能提升228.57%。ParaCache缓存管理方案,采用曙光ParaStor分布式存储和FlashNexus集中式存储,构建高性价比的生产级L4 KV Cache池,实现TTFT降低95%+,Token吞吐性能提升15~25倍,64K上下文并发数提升16倍等目标,并可将单TB成本降至内存方案的四十分之一。
从算存网产品到推理优化服务,中科曙光将系统研发、工程实施与持续运营连接起来,使智算基础设施既能承接更大的业务规模,也能在长期使用中保持效率与稳定性,持续支撑模型迭代和应用发展。
